Automatically Scraping Workout Data with Playwright + Alibaba Cloud OCR and Showing It in Hexo
Recently I needed to sync my personal training records from a certain sports website (RQ Run) into my Hexo blog. Because the site requires login to vi...
祝君万事如意心想事成!
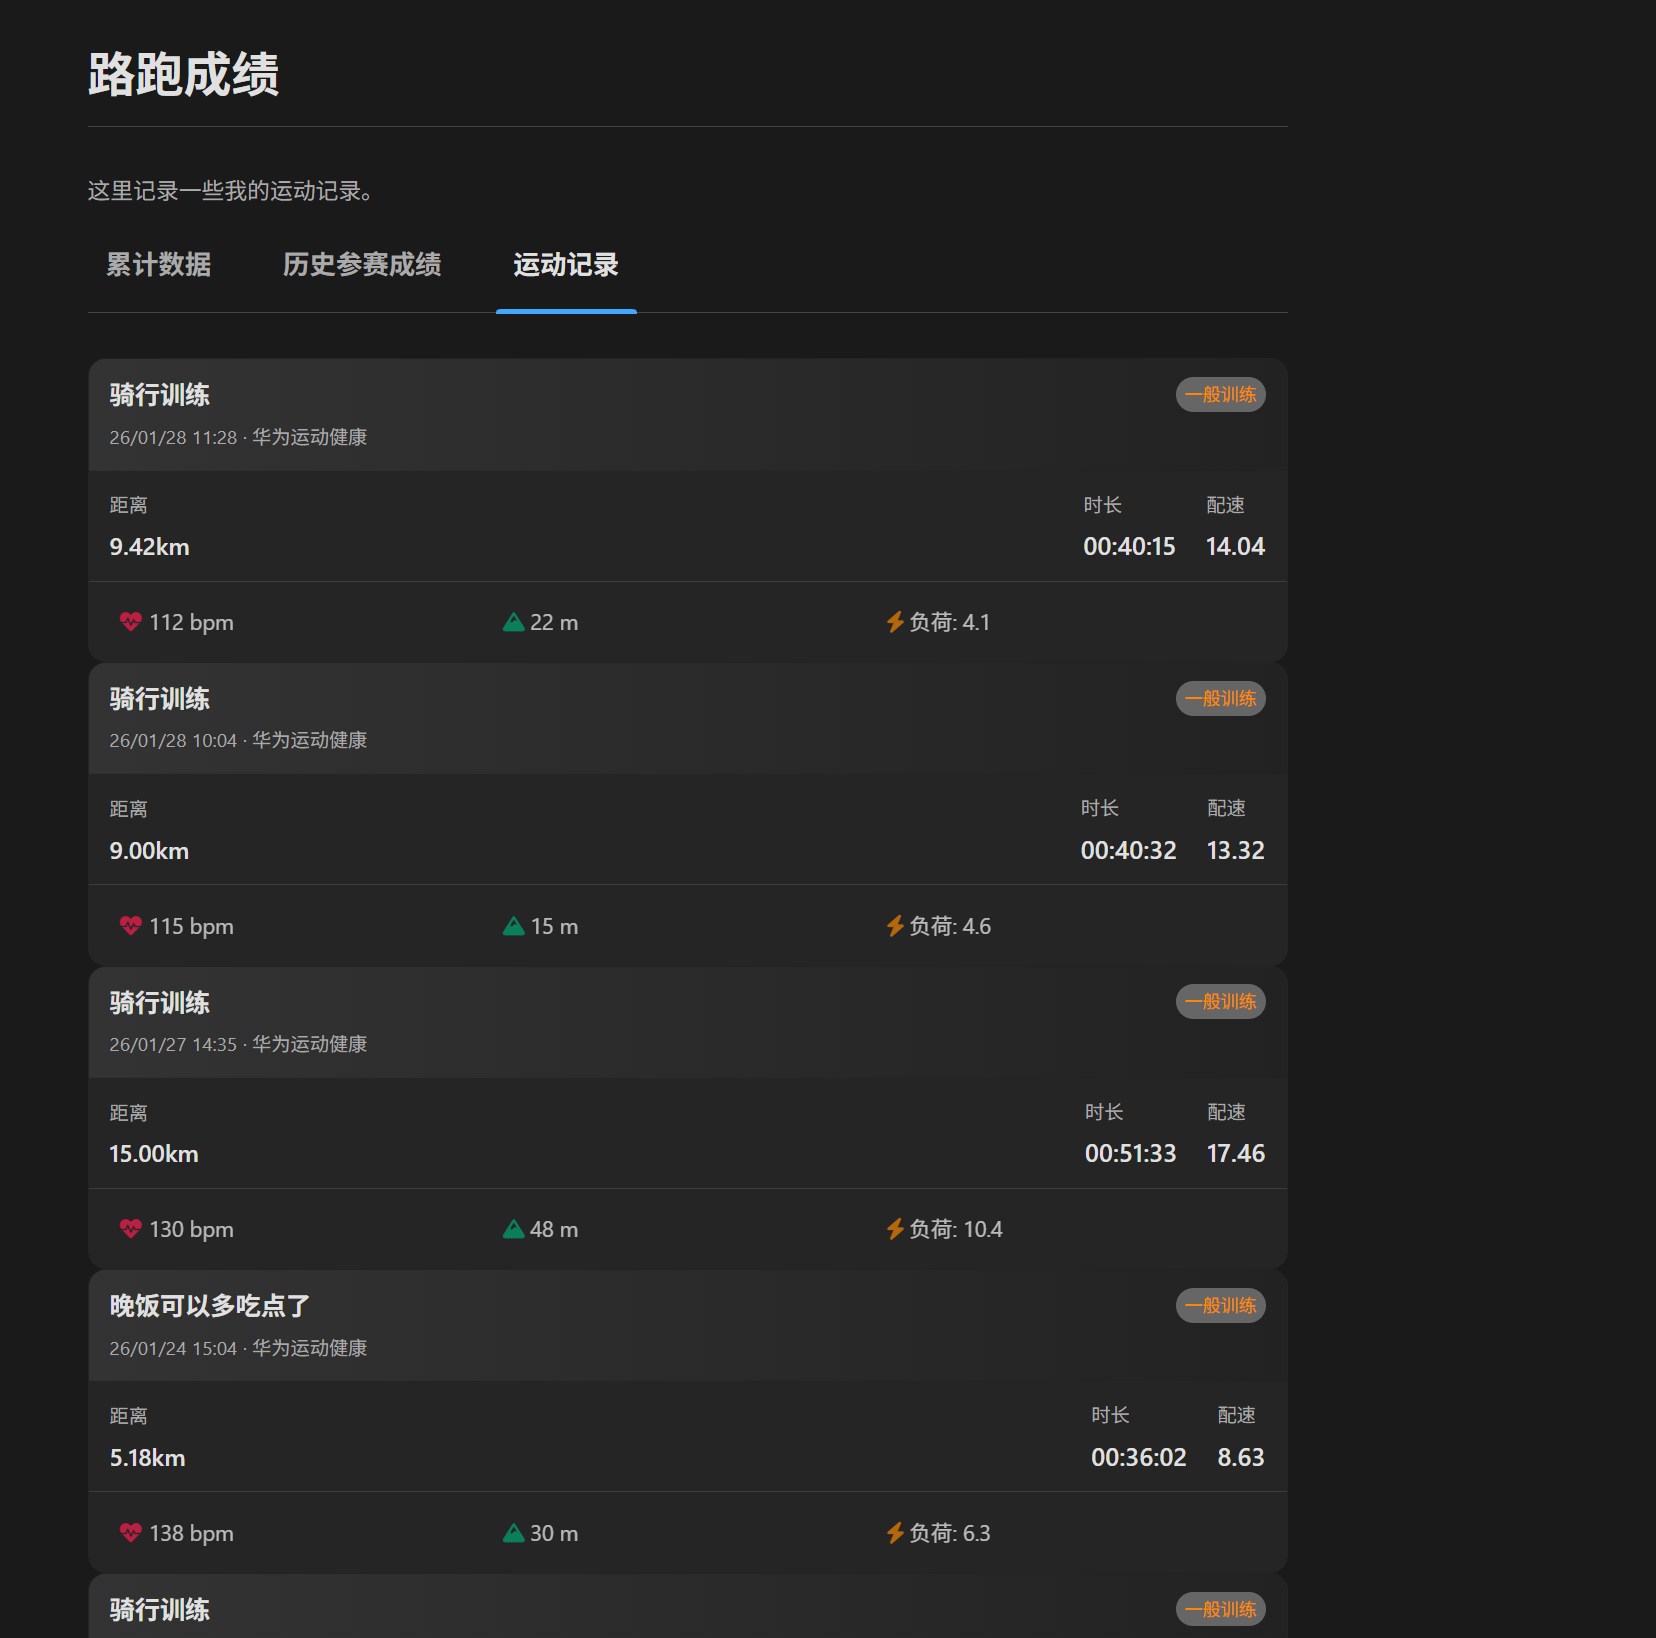
Recently I needed to sync my personal training records from a certain sports website (RQ Run) into my Hexo blog. Because the site requires login to vi...
最近我需要将某个运动网站(RQ Run)上的个人训练记录同步到我的 Hexo 博客中。由于该网站需要登录才能查看详细数据,并且登录过程包含验证码,因此我使用 Node.js 版的 Playwright 编写了一个自动化脚本,结合阿里云 OCR 服务识别验证码,实现了数据的自动抓取,并通过 EJS 模...

在 Python 爬虫的世界里,如果说 requests 是负责“把网页拿回来”的搬运工,那么 BeautifulSoup 就是负责“从网页里找东西”的寻宝专家。 BeautifulSoup(通常指 bs4)是一个用于从 HTML 或 XML 文件中提取数据的 Python 库。它以简单 Pytho...

在 Web 自动化测试和爬虫领域,Selenium 统治了很长一段时间。但随着现代 Web 技术的发展,Selenium 的速度和稳定性逐渐成为瓶颈。微软开源的 Playwright 横空出世,支持 Chromium、Firefox 和 WebKit 三大浏览器引擎,并且速度极快,API 设计也非常...

提到无头浏览器(Headless Browser),大家首先想到的可能是 Google 出品的 Puppeteer。不过 Puppeteer 是 Node.js 库,对于 Python 开发者来说,直接调用有些麻烦。好在社区移植了一个 Python 版本——Pyppeteer。 虽然现在 Playw...
Recently I needed to sync my personal training records from a certain sports website (RQ Run) into my Hexo blog. Because the site requires login to vi...
Recently I needed to sync my personal training records from a certain sports website (RQ Run) into my Hexo blog. Because the site requires login to vi...
在 Python 爬虫的世界里,如果说 requests 是负责“把网页拿回来”的搬运工,那么 BeautifulSoup 就是负责“从网页里找东西”的寻宝专家。 BeautifulSoup(通常指 bs4)是一个用于从 HTML 或 XML 文件中提取数据的 Python 库。它以简单 Pytho...
在 Web 自动化测试和爬虫领域,Selenium 统治了很长一段时间。但随着现代 Web 技术的发展,Selenium 的速度和稳定性逐渐成为瓶颈。微软开源的 Playwright 横空出世,支持 Chromium、Firefox 和 WebKit 三大浏览器引擎,并且速度极快,API 设计也非常...
提到无头浏览器(Headless Browser),大家首先想到的可能是 Google 出品的 Puppeteer。不过 Puppeteer 是 Node.js 库,对于 Python 开发者来说,直接调用有些麻烦。好在社区移植了一个 Python 版本——Pyppeteer。 虽然现在 Playw...